7.1 为什么深层网络需要正则化与归一化

前面的章节里,我们已经学会了如何搭建神经网络、计算梯度并更新参数。从理论上看,只要 loss 能够下降,模型似乎就应该越来越好。但真正训练一个更深、更大的神经网络时,我们很快会遇到两个完全不同的问题。
第一个问题是:模型在训练集上越来越好,但在没有见过的数据上不一定更好。模型可能只是记住了训练数据中的细节,甚至把噪声也学了进去。这是泛化问题,也是正则化主要想解决的问题。
第二个问题是:模型虽然有足够的表达能力,但训练过程本身可能越来越难控制。随着网络不断加深,中间特征的尺度会经过很多层连续变换,某些层的 activation 可能越来越大,某些层越来越小,不同 batch、不同层之间的数值范围也可能不断变化。这样会让优化器更难选择一个合适的更新尺度。这是优化稳定性问题,也是 normalization 主要想解决的问题。
所以,虽然我们经常把 regularization 和 normalization 放在同一章里讨论,但它们并不是同一类方法:
Regularization 主要关心模型学得是不是太贴合训练数据,Normalization 主要关心模型能不能以稳定的数值尺度进行训练。
这一章会围绕这两个问题展开。我们先在这一节建立整体框架,然后分别学习 Dropout、BatchNorm、LayerNorm、InstanceNorm、GroupNorm 和 RMSNorm。
7.1.1 两类问题:泛化与优化稳定性
假设我们有一个模型 \(f_\theta\),参数为 \(\theta\)。训练时,我们真正能够直接最小化的是训练集上的经验损失:
\[ \mathcal{L}_{\mathrm{train}}(\theta) = \frac{1}{N}\sum_{i=1}^{N} \ell(f_\theta(x_i), y_i) \]
优化器做的事情,就是不断更新 \(\theta\),让这个量变小。
但是,我们真正关心的并不是模型有没有把训练集做对,而是它面对新的样本时表现如何。理想情况下,我们希望训练损失下降的同时,验证集和测试集上的损失也一起下降。
现实中却经常出现下面这种情况:
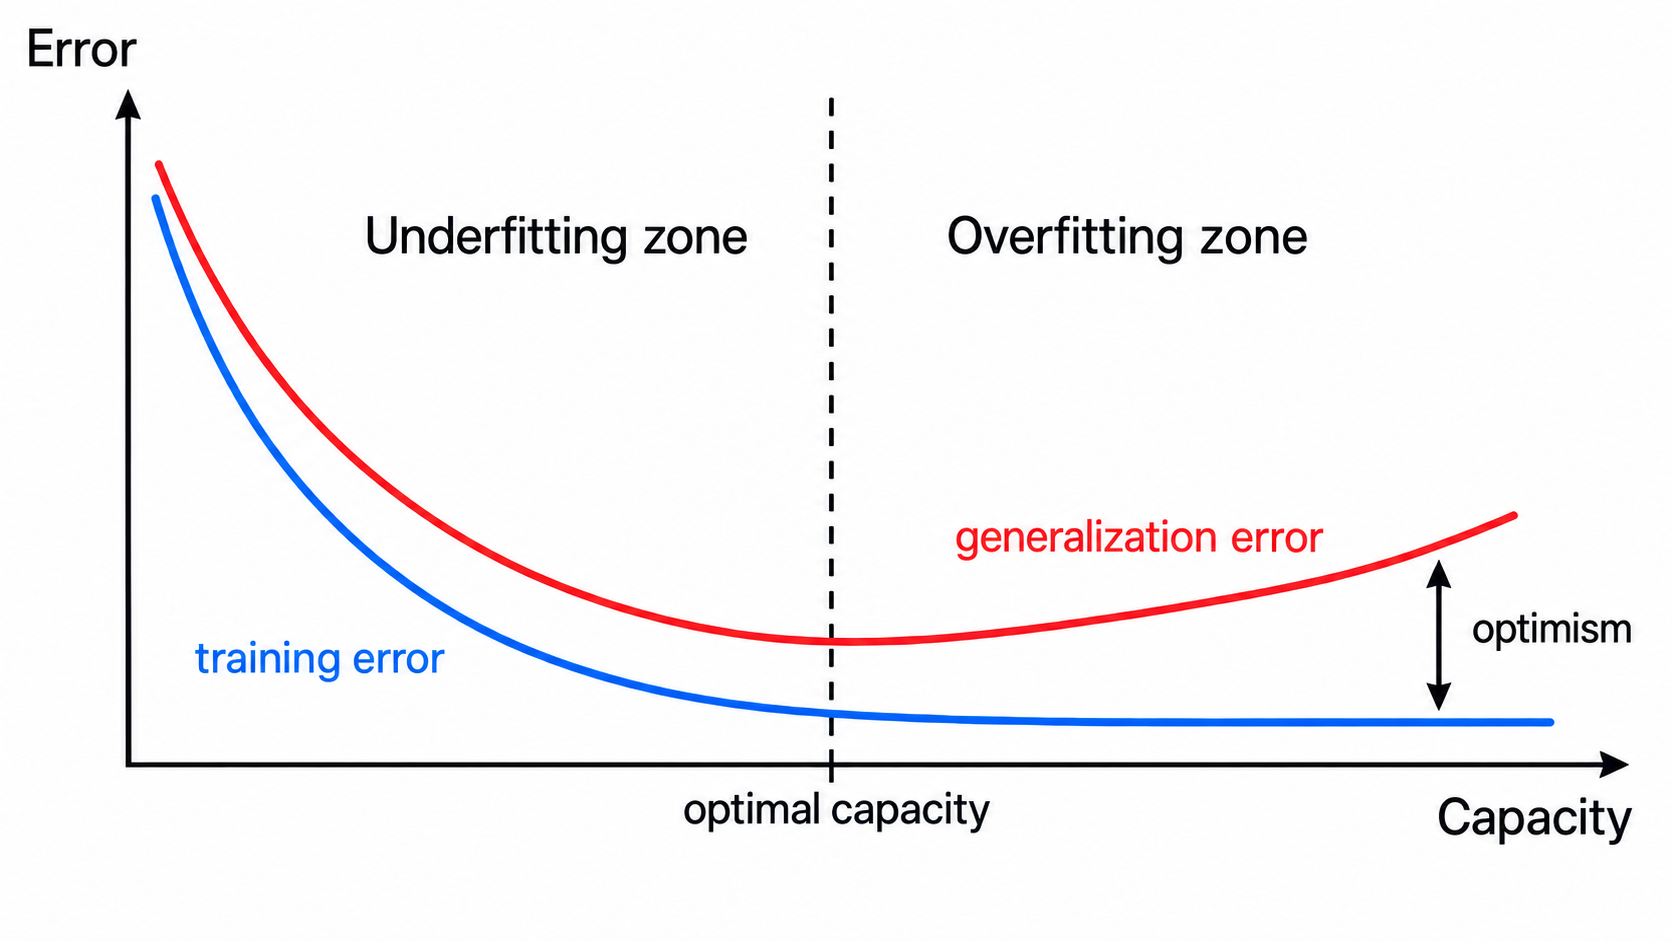
模型继续记住训练集之后,training loss 还在下降,但 validation loss 已经开始变差。这就是典型的过拟合。
而另一种问题发生在训练过程内部。即使模型还没有过拟合,深层网络也可能出现:
- 某些层 activation 很大;
- 某些层 activation 很小;
- 不同层的尺度差异越来越明显;
- 参数更新对 learning rate 非常敏感;
- 训练过程出现明显震荡甚至发散。
这时问题并不是模型记住了训练集,而是参数很难被稳定地优化。
因此,我们可以先把这一章分成两条线:

这个区分很重要。否则很容易把所有“让训练更好”的技巧都混成一类,却不知道它们到底在解决什么问题。
7.1.2 训练损失低,不代表模型真的学会了
神经网络的参数量通常很大,因此它可以表示非常复杂的函数。表达能力强当然是好事,因为模型能够拟合更复杂的数据规律;但另一方面,它也意味着模型有能力把训练数据中的偶然模式一起学进去。
例如,假设训练集中猫的照片大多来自室内,而狗的照片大多来自室外。一个足够强的模型可能发现:
- 绿色草地 → 更可能是狗
- 室内沙发 → 更可能是猫
这些模式确实可以降低 training loss,但它们并不是我们真正希望模型学习的“猫”和“狗”的视觉特征。一旦测试集中的背景分布发生变化,模型的表现就可能明显下降。所以,训练神经网络并不是单纯地追求:
\[ \mathcal{L}_{\mathrm{train}} \rightarrow 0 \]
我们真正希望的是模型学到能够迁移到新数据上的规律,也就是获得更好的 generalization。
需要注意的是,不能简单地说“模型越大就一定越容易过拟合”。现代深度学习中,大模型即使参数量远大于训练样本数量,也可能拥有很好的泛化能力。模型最终是否过拟合,还会受到数据量、数据噪声、优化算法、训练时间、模型结构和隐式偏置等很多因素影响。更准确的说法是:
模型容量越大,它能够表示的函数越复杂,因此也更有能力拟合训练数据中的噪声和偶然模式。是否真的发生过拟合,还取决于整个训练过程。
这也是为什么我们需要 regularization。它不是单纯让模型变弱,而是在很多可能的拟合方式中,尽量让优化过程更偏向能够泛化的那一种。
7.1.3 Regularization 到底在限制什么
Regularization 通常翻译为正则化。它并不对应某一个固定算法,而是一组用来改善泛化的方法。
最经典的思路是在训练目标里加入额外约束。例如,原本我们只最小化数据损失:
\[ \min_\theta \mathcal{L}_{\mathrm{train}}(\theta) \]
加入正则项以后,可以写成:
\[ \min_\theta \mathcal{L}_{\mathrm{train}}(\theta) + \lambda \Omega(\theta) \]
其中,\(\Omega(\theta)\) 表示我们希望施加的约束,\(\lambda\) 控制正则化强度。
比如 weight decay 会限制参数尺度,dropout 会在训练过程中随机屏蔽部分神经元,data augmentation 会通过改变训练样本来增加模型真正需要适应的数据变化,early stopping 则会在模型开始过拟合之前停止训练。
这些方法的形式差别很大,但它们有一个共同目标:
不要让模型只寻找最容易把训练集做对的解,而是让它更倾向于学习能够推广到新数据的表示。
这一章不会重新展开所有 regularization 方法。Weight decay 已经和优化器联系得很紧,data augmentation 又和具体任务有关。我们会重点讨论神经网络里最经典的一种结构性正则化方法:Dropout。Dropout 的思路非常直接:训练时随机让一部分神经元暂时失效,让网络不能过度依赖某一条固定的信息路径。下一节我们会单独实现它,并讨论为什么训练和推理阶段的行为不同。
7.1.4 网络变深以后,数值尺度也会不断传播
除了泛化之外,深层网络还有另一个问题:每一层都在改变上一层输出的表示。
考虑一个最简单的线性层:
\[ h^{(l+1)} = W^{(l)} h^{(l)} + b^{(l)} \]
如果再经过激活函数,就变成:
\[ h^{(l+1)} = \phi\left(W^{(l)} h^{(l)} + b^{(l)}\right) \]
一层看起来没有什么问题。但如果连续堆叠几十层甚至几百层,同样的变换会重复很多次:
\[ h^{(0)} \rightarrow h^{(1)} \rightarrow h^{(2)} \rightarrow \cdots \rightarrow h^{(L)} \]
这时,中间表示的数值尺度会受到前面所有层共同影响。假设某些层不断把输入放大,activation 的方差可能逐层增长;反过来,如果连续缩小,后面的 activation 也可能越来越接近 0。
反向传播也有类似问题。根据链式法则,梯度需要连续乘上很多层的 Jacobian:
\[ \frac{\partial \mathcal{L}}{\partial h^{(l)}} = \frac{\partial \mathcal{L}}{\partial h^{(L)}} \frac{\partial h^{(L)}}{\partial h^{(L-1)}} \cdots \frac{\partial h^{(l+1)}}{\partial h^{(l)}} \]
如果这些变换的尺度长期偏大或者偏小,梯度就可能出现 exploding 或 vanishing。
当然,现代网络并不是只靠 normalization 解决这些问题。合适的参数初始化、激活函数、残差连接和优化器都非常重要。Normalization 更准确的作用,是让某些中间表示保持在更可控的统计尺度上,从而降低深层网络的优化难度。
7.1.5 Normalization 在稳定什么
Normalization 的核心思想,可以先抽象成一句话:
先选择一组元素计算统计量,再利用这些统计量重新调整特征的尺度。
最常见的形式类似:
\[ \hat{x} = \frac{x-\mu}{\sqrt{\sigma^2+\epsilon}} \]
其中,\(\mu\) 和 \(\sigma^2\) 分别是某一组元素上的均值和方差,\(\epsilon\) 用来避免除零。
归一化之后,通常还会加入可学习的缩放和平移参数:
\[ y = \gamma \hat{x} + \beta \]
这一步很重要。Normalization 并不是强迫所有特征永远保持均值 0、方差 1,而是先把输入变换到一个更可控的尺度,再让模型通过 \(\gamma\) 和 \(\beta\) 学习自己真正需要的范围。
不同 normalization 方法之间最关键的区别,其实不是上面的公式,而是:
\(\mu\) 和 \(\sigma^2\) 到底在哪些维度上计算?
例如,对于一个形状为 (N, C, H, W) 的图像张量,不同方法可能选择:
- 跨 batch 统计;
- 在单个样本内部统计;
- 对每个 channel 单独统计;
- 把多个 channel 分成 group 后统计;
- 甚至只使用 RMS,而不减去均值。
这就产生了后面要学习的 BatchNorm、LayerNorm、InstanceNorm、GroupNorm 和 RMSNorm。
因此,理解 normalization 最重要的不是死记每个公式,而是始终问两个问题:
- 哪些元素被放在一起计算统计量?
- 这些统计量在 training 和 inference 时是否相同?
等学完这一章后,我们会在 7.8 从这个统一视角重新比较所有 normalization 方法。
7.1.6 Normalization 不是简单地防止梯度消失
Normalization 有时会被简单解释成防止梯度消失和梯度爆炸。这个说法太粗糙了。
首先,梯度是否稳定不只由 activation 的均值和方差决定。网络深度、参数初始化、非线性函数、残差结构和优化器都会影响梯度传播。即使加入 normalization,也不能保证梯度永远不会爆炸或消失。
其次,normalization 的价值不仅体现在梯度大小上。它还会改变参数空间中的优化几何,让不同层看到的输入尺度更可预测,通常也会降低训练对初始化和 learning rate 的敏感程度。
BatchNorm 最初提出时,一个重要解释是减少所谓的 internal covariate shift。这个解释很有影响力,但后来研究发现,BatchNorm 的效果不能完全用 internal covariate shift 来解释。因此,我们在这里不把它当成 normalization 的统一原理。
更稳妥的理解是:
Normalization 通过控制中间表示的统计尺度,使深层网络中的数值传播和参数优化更加可控。不同 normalization 的具体效果和机制并不完全相同。
这也是为什么现在的 CNN 和 Transformer 会使用不同的 normalization 设计。CNN 中 BatchNorm 很常见,而现代 Transformer 更常见的是 LayerNorm 或 RMSNorm。它们不是谁绝对更好,而是适合的张量结构、batch 条件和网络架构不同。
7.1.7 Regularization 和 Normalization 不要混为一谈
到这里,我们可以把两条线放在一起比较。
| 种类 | Regularization | Normalization |
|---|---|---|
| 主要问题 | 泛化能力与过拟合 | 优化稳定性与特征尺度 |
| 核心问题 | 模型是否过度适应训练数据 | 中间表示是否处在可控的统计尺度 |
| 常见方法 | Dropout、Weight Decay、Data Augmentation、Early Stopping | BatchNorm、LayerNorm、InstanceNorm、GroupNorm、RMSNorm |
| 是否一定改变 activation 统计量 | 不一定 | 通常会 |
| 是否一定具有正则化效果 | 设计目标通常就是改善泛化 | 不一定 |
这里最后一行尤其值得注意。例如 BatchNorm 使用 mini-batch 的统计量,因此训练时会引入和 batch 有关的随机性,在某些情况下确实可能产生一定的 regularization 效果。但这并不意味着 normalization 本质上就是 regularization;LayerNorm 和 RMSNorm 在 Transformer 中被大量使用,主要原因并不是防止过拟合,而是为了让深层网络更容易优化。它们通常在单个样本内部计算统计量,也没有 BatchNorm 那种依赖 batch 统计量带来的随机性。
所以,更准确的关系是:

它们可以同时出现在同一个模型中,也可能彼此产生交叉影响,但不能因此把两个概念当成同义词。
7.1.8 本章小结
接下来,我们会沿着刚才的两条线继续。
首先是 Dropout。它代表 regularization 这条线:训练时随机关闭部分神经元,减少模型对固定特征和固定计算路径的依赖。
然后进入 normalization。我们会依次学习:
- BatchNorm:利用 batch 中多个样本的统计量进行归一化;
- LayerNorm:在单个样本内部对 feature 维度进行归一化;
- InstanceNorm:对每个样本、每个 channel 分别进行归一化;
- GroupNorm:把 channel 分组后计算统计量;
- RMSNorm:不做均值中心化,只根据 RMS 调整特征尺度。
最后在 7.8,我们不会再把它们当成几个独立公式,而是统一回到一个问题:
对于一个给定张量,统计量到底沿哪些维度计算?
理解这一点之后,很多 normalization 的公式其实都只是同一个模板在不同维度上的变化。
所以,这一章真正需要建立的是两个判断框架:
- 模型是不是过度适应训练数据?
- 中间表示和优化过程是不是难以稳定控制?
下一节,我们先从第一条线开始,看看 Dropout 如何通过随机失活来减少过拟合。